¿Qué son los tokens?
Y por qué un modelo nunca lee tus palabras.
ChatGPT, Claude, Gemini: los productos que la mayoría usamos día a día funcionan en base a modelos de lenguaje de gran tamaño, conocidos como LLM por sus siglas en inglés. Al contrario de lo que podrías pensar, no entienden el lenguaje; al menos no como lo entendemos los humanos.
Parte de la confusión viene del nombre. Modelo de lenguaje es un término antiguo de la ciencia de la computación para un programa que, dado un texto, predice lo que viene a continuación. Describe lo que el modelo hace con el lenguaje, no si entiende algo de él. Y la forma en la que usamos estos modelos hace aún más fácil caer en el malentendido:
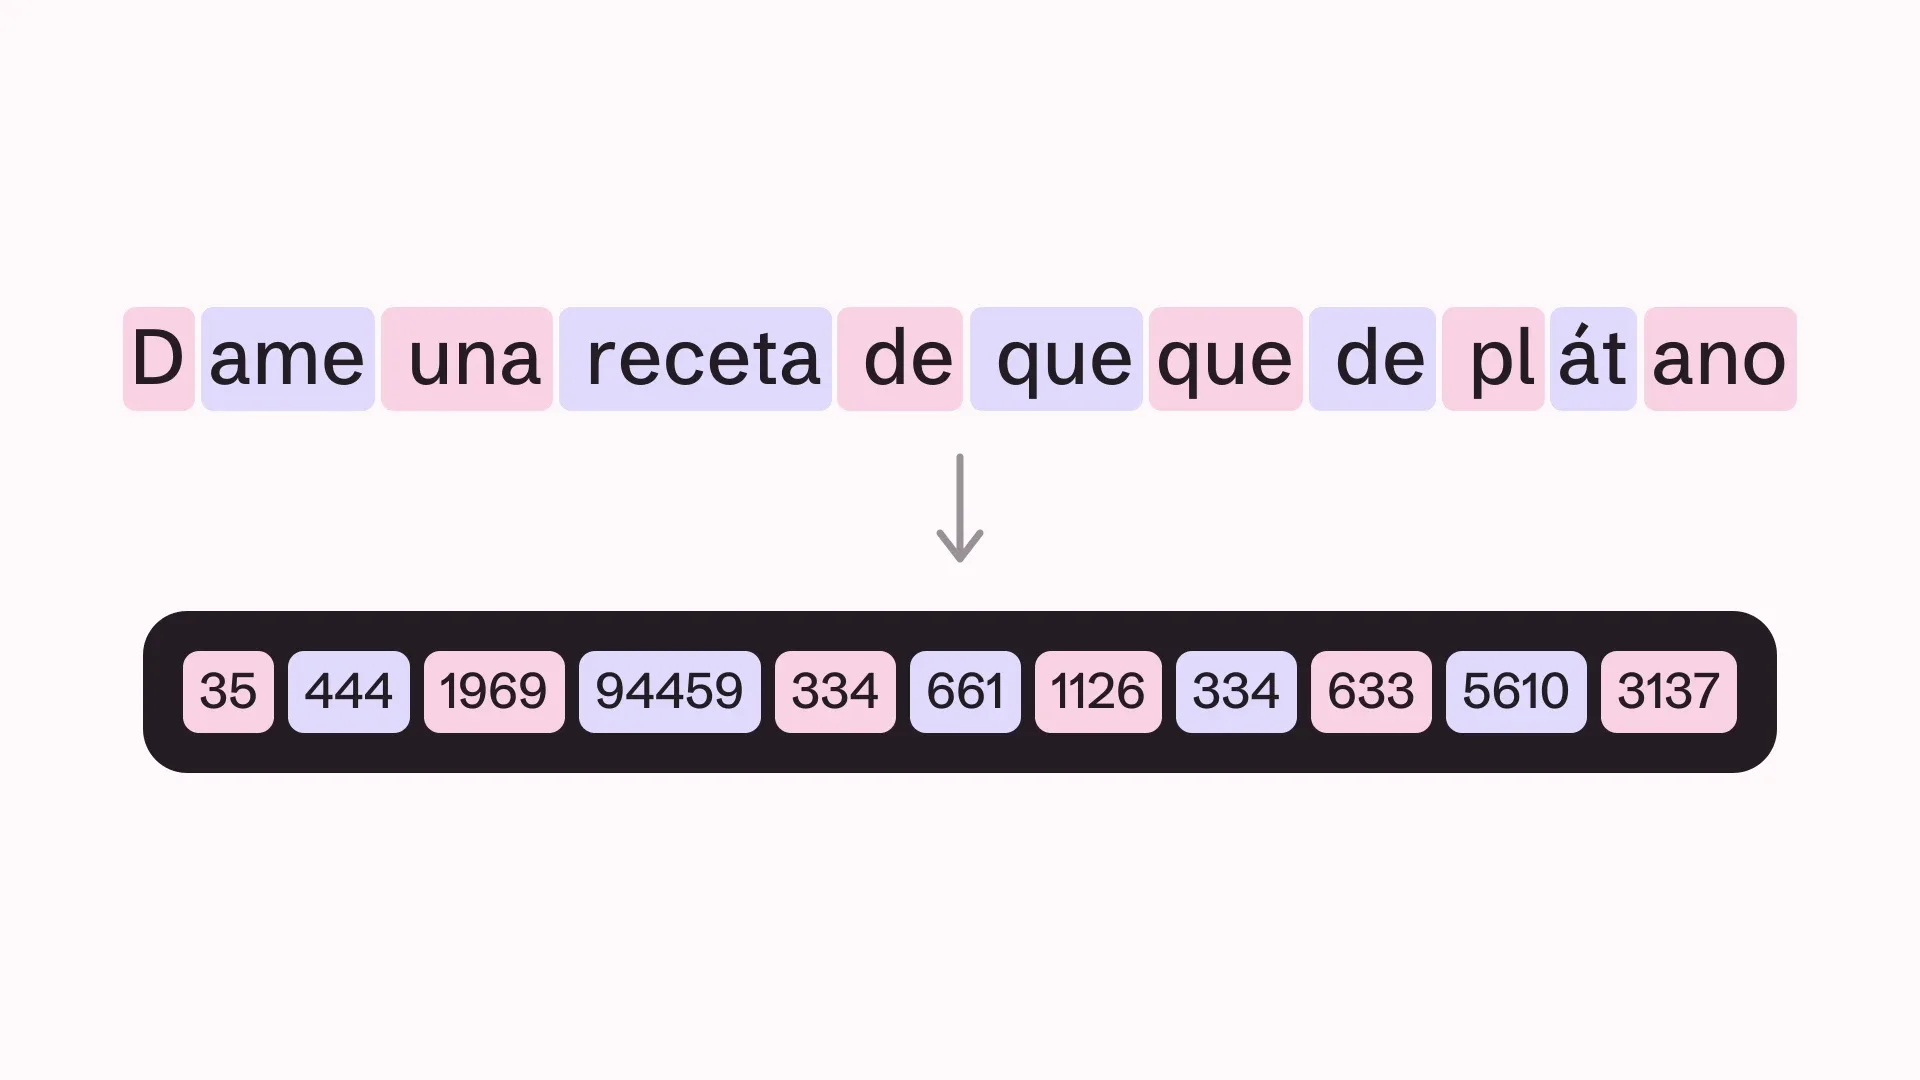
- Tú: Dame una receta de queque de plátano
- LLM: ¡Claro! Aquí tienes una receta de queque de plátano clásico...
Claro: entra texto, sale texto. Y el texto es lenguaje. Así que es natural suponer que, en algún punto intermedio, el modelo está leyendo tus palabras. No es así.
Piensa en una calculadora. Pones 7 + 5 y aparece 12, pero adentro no hay ningún 7 ni ningún 12, solo señales eléctricas que se prenden y se apagan. Los dígitos están ahí para ti. La calculadora es excelente haciendo cálculos sin haber visto nunca un número como lo ves tú.
Con los LLM pasa algo parecido. Tú escribes palabras y recibes palabras, pero entre una cosa y otra, el modelo no trabaja con palabras. A lo que voy: que hablemos con los LLM en lenguaje no significa que lo procesen como lenguaje. Si ahí dentro hay alguna forma de comprensión (y yo creo que sí), no ocurre en palabras.
Entonces, si un LLM no trabaja con palabras, ¿con qué trabaja? Con tokens.
Qué es un token
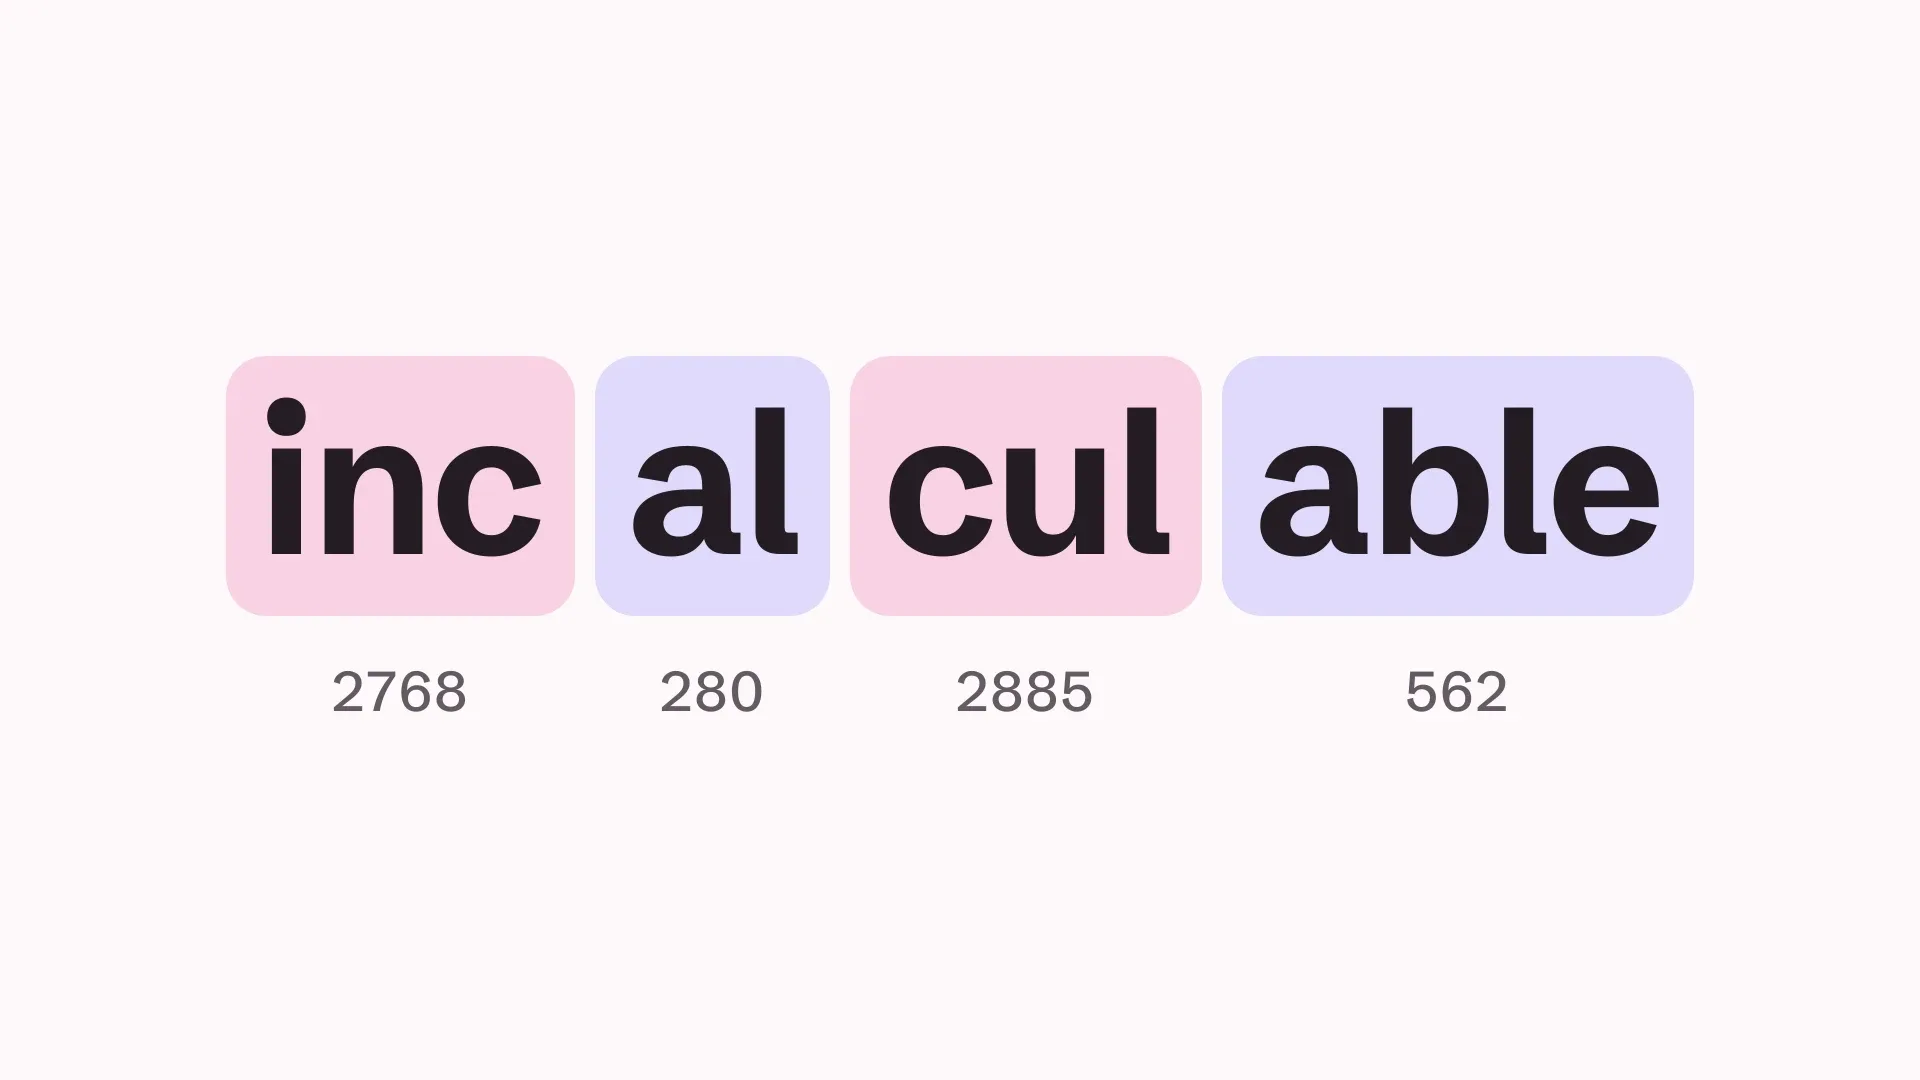
Un token es un fragmento de texto. Antes de que tu mensaje llegue al modelo, un programa aparte, el tokenizador, lo corta en fragmentos sacados de una lista fija, su vocabulario, y reemplaza cada fragmento por su número en esa lista. Esos números son lo único que recibe el modelo.
La portada de este artículo es otro ejemplo. El tokenizador de GPT-4o corta incalculable en cuatro fragmentos:
inc (2768) · al (280) · cul (2885) · able (562)
Las palabras comunes suelen tener un token propio, mientras que las más largas o raras se dividen en pedazos. El vocabulario del tokenizador de GPT-4o tiene unos 200.000 fragmentos; el de GPT-4 tenía unos 100.000.
Cambios pequeños producen números distintos. Con un espacio delante, como aparece en medio de una frase, incalculable empieza con inc (4570) en vez de inc (2768). Con mayúscula inicial, se divide de otra forma: In · calcul · able. Nada en esos números dice que se trata de la misma palabra. El modelo lo aprende al verlos usados de la misma manera en su texto de entrenamiento.
Un ID de token es solo una etiqueta. Dentro del modelo, cada uno se reemplaza de nuevo, esta vez por una larga lista de números aprendida durante el entrenamiento. Los tokens que se usan de formas parecidas terminan con listas parecidas, y el modelo hace sus cálculos con esas listas.
Cómo se eligen los fragmentos
Nadie escribe el vocabulario a mano. Se aprende de un gran volumen de texto antes de entrenar el modelo, y los tokenizadores de OpenAI lo aprenden con un método llamado byte pair encoding (codificación por pares de bytes):
- Se parte de caracteres sueltos (en estricto rigor, bytes).
- Se busca el par de vecinos que aparece más veces y se une en un token nuevo.
- Se repite hasta llenar el vocabulario.
El tokenizador de GPT-2, de 2019, numera sus tokens en el orden en que los aprendió. El primer par que unió fue un espacio seguido de una t. Después vinieron un espacio y una a, luego he, in, re y on. En la séptima unión ya tenía the, el artículo definido del inglés.
Las secuencias frecuentes se vuelven un solo token y las raras quedan en pedazos. Las divisiones salen solo de la frecuencia, sin atender a sílabas ni a significados, y por eso incalculable termina cortada entre al y cul. Una vez entrenado, el tokenizador queda fijo, y el modelo aprende todo lo que sabe de texto que ya pasó por él.
¿Por qué no palabras enteras, o letras sueltas?
Un vocabulario de palabras enteras nunca estaría completo. Cada nombre, cada error de tipeo y cada conjugación de cada idioma necesitaría su entrada, y cualquier palabra que faltara no se podría leer ni escribir. Con pedazos, cualquier cosa se puede armar, byte a byte si hace falta, así que tokenizadores como los de OpenAI nunca se topan con un texto que no puedan manejar.
Las letras sueltas fallan en el sentido contrario. La introducción de este artículo tiene 1.506 caracteres, pero solo 358 tokens, así que leerla letra por letra la haría más de cuatro veces más larga. El trabajo de un modelo crece con el largo de lo que lee, y también crece el espacio que ese texto ocupa en su ventana de contexto, el límite de cuánto texto puede recibir de una vez.
Los tokens quedan entre ambos extremos, y así el vocabulario tiene un tamaño finito y el texto se mantiene corto.
Lo que los tokens explican
Cuando sabes que un modelo lee fragmentos numerados, algunos de sus errores más conocidos empiezan a tener sentido.
Contar letras en naranja
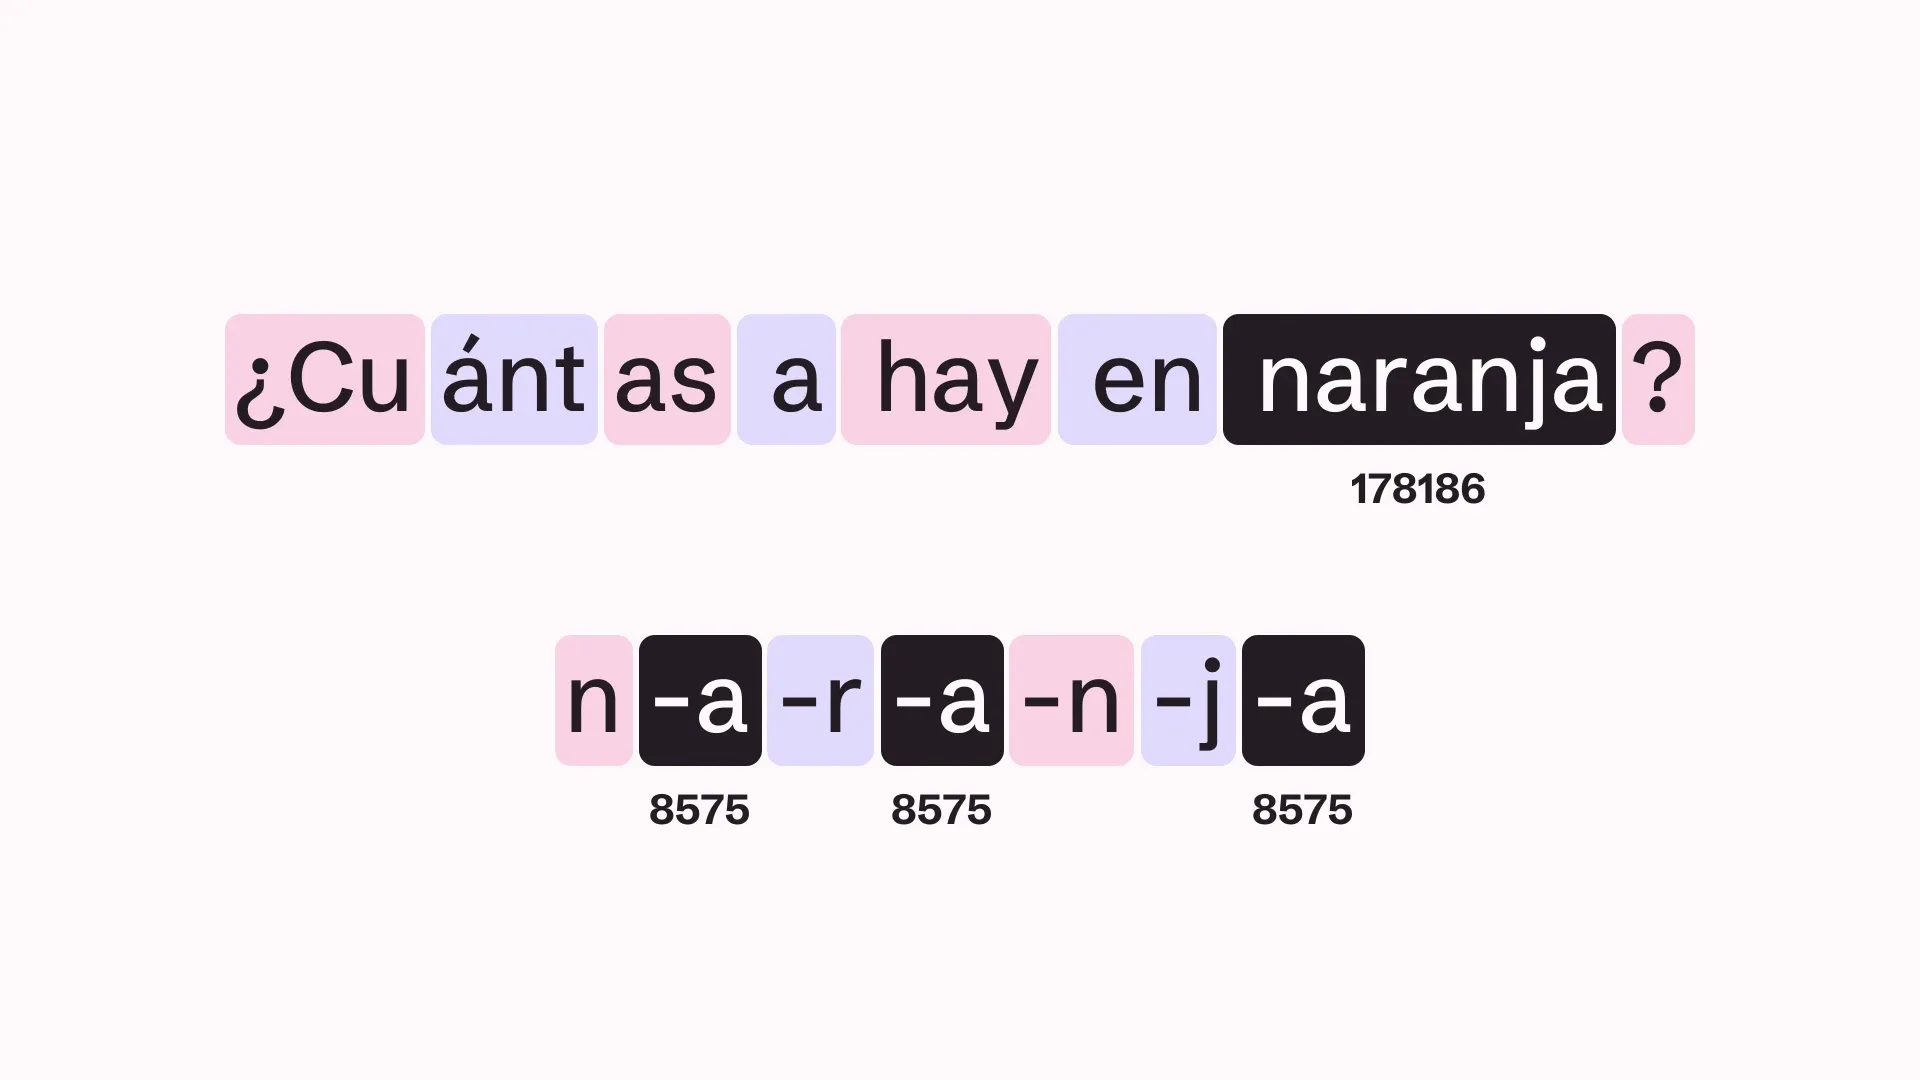
La versión más conocida de esta pregunta, en inglés, pide contar las r de strawberry. En español pasa lo mismo con naranja. "¿Cuántas a hay en naranja?" ocupa ocho tokens, y uno de ellos, el 178186, es naranja, con espacio incluido. El modelo recibe ese único número. Las letras no están ahí, así que tiene que responder con lo que haya aprendido durante su entrenamiento sobre cómo se escribe el token 178186.
Si deletreas la palabra como n-a-r-a-n-j-a, pasa a ser siete tokens, y cada a aparece como el mismo token, -a (8575). Ahora sí hay algo que contar. Los modelos más nuevos suelen acertar la pregunta de strawberry, y a cualquier modelo le ayuda que le pidas deletrear una palabra antes de contar sus letras.
Todo lo que depende de letras sueltas choca con el mismo muro: invertir una palabra, resolver un anagrama, contar sílabas.
Cuántas palabras tiene tu ensayo
Los tokens no coinciden con las palabras. La introducción de este artículo tiene 270 palabras y 358 tokens; la versión en inglés, 243 palabras y 298 tokens. La proporción cambia con el vocabulario, la puntuación, los números y el idioma, así que conocer una cifra no te da la otra.
Contar también requiere llevar la cuenta, y mantener una cuenta exacta a lo largo de miles de tokens es difícil para estos modelos en general. Los tokens empeoran el problema, porque el modelo lee tokens y tú preguntaste por palabras. Lo mismo pasa con "escribe exactamente 500 palabras". Si la app que usas puede ejecutar código, pídele que cuente con código.
Por qué algunos idiomas cuestan más
Un tokenizador solo aprende fragmentos que aparecen a menudo en su texto de entrenamiento. Cuando la mayor parte de ese texto está en inglés, las palabras inglesas se vuelven tokens enteros, mientras que otros idiomas dejan más de sus palabras en pedazos.
Este es el artículo 1 de la Declaración Universal de Derechos Humanos en los seis idiomas oficiales de la ONU1, contado con el tokenizador de GPT-4 y con el de GPT-4o:
| Idioma | GPT-4 | GPT-4o |
|---|---|---|
| Inglés | 33 | 33 |
| Español | 44 (1,3×) | 38 (1,2×) |
| Francés | 50 (1,5×) | 41 (1,2×) |
| Ruso | 74 (2,2×) | 41 (1,2×) |
| Árabe | 91 (2,8×) | 44 (1,3×) |
| Chino | 50 (1,5×) | 35 (1,1×) |
La versión en árabe dice lo mismo que la inglesa y ocupa casi el triple de tokens con el tokenizador de GPT-4. Más tokens significa pagar más por la misma consulta, esperar más la respuesta y tener menos espacio libre en la ventana de contexto. En un conjunto mucho más amplio de idiomas, investigadores de la Universidad de Oxford encontraron diferencias de hasta 15 veces2.
El tokenizador de GPT-4o reduce buena parte de esa brecha. Con el doble de vocabulario, tiene espacio para más fragmentos de más idiomas. Aun así, el inglés sigue saliendo mejor parado. La introducción de este artículo ocupa un 20% más de tokens en español que en inglés, y un 36% más con el tokenizador de GPT-4.
Números largos
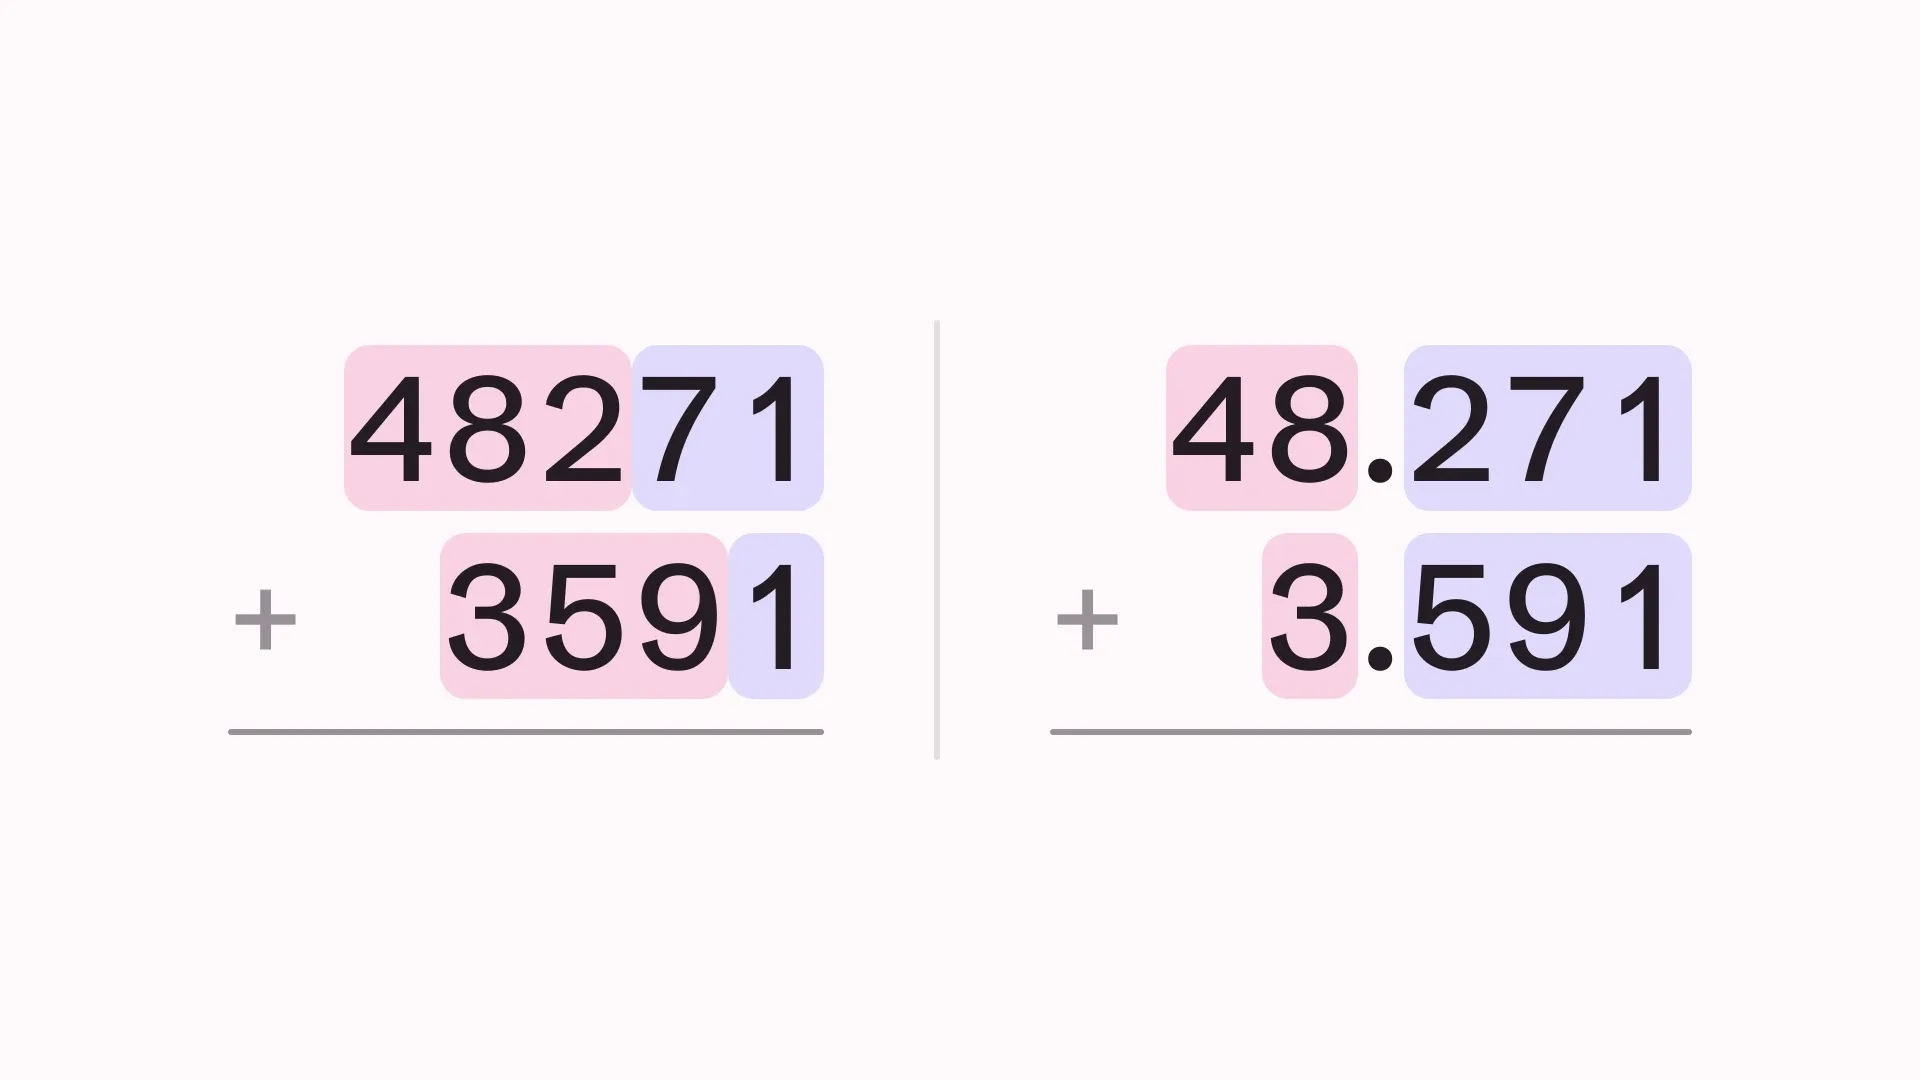
El tokenizador de GPT-4o lee los números en grupos de hasta tres cifras, empezando por la izquierda. 48271 queda como 482 · 71, y 3591, como 359 · 1. Para sumarlos, un modelo tiene que alinear unidades con unidades y decenas con decenas, y estos grupos no se alinean así. El último grupo del primer número, 71, tiene decenas y unidades, mientras que el último del segundo, 1, tiene solo unidades.
Los separadores de miles lo arreglan. Escritos como 48.271 y 3.591, los números se dividen en 48 · . · 271 y 3 · . · 591, y los dos grupos de tres cifras tienen centenas, decenas y unidades. En un estudio de 2024, separar los miles con comas, como se hace en inglés, subió la precisión de GPT-3.5 al sumar números de siete a nueve cifras del 75,6% al 97,8%3. Cuando una app de chat puede ejecutar código, puede dejarle la aritmética a ese código.
Una palabra que el modelo no podía decir
El tokenizador y el modelo se entrenan por separado, con textos distintos, y a veces se nota. GPT-2 y GPT-3 compartían un tokenizador que tenía SolidGoldMagikarp como un solo token, el 43453. Era el nombre de usuario de uno de los miembros más activos de r/counting, una comunidad de Reddit que lleva años contando hasta el infinito, un comentario a la vez, así que aparecía constantemente en el texto del que aprendió el tokenizador. Lo más probable es que el texto de entrenamiento del modelo dejara fuera esos hilos, lo que le dio un token del que nunca aprendió nada.
A principios de 2023, Jessica Rumbelow y Matthew Watkins encontraron más de cien tokens como ese4. Cuando se les pedía repetir "SolidGoldMagikarp", los modelos de OpenAI de la época respondían con algo totalmente distinto, como "distribute". El tokenizador de GPT-4o divide el nombre en cinco pedazos comunes.
Tokens y dinero
Los precios se publican por millón de tokens, así que es fácil pensar en los tokens como una unidad de costo. Miden texto. Lo que pagas por una consulta depende del modelo, de cuántos tokens entran y salen, y de tokens que nunca ves.
Los modelos más grandes cuestan más por token, y en la oferta de una misma empresa el modelo más grande puede costar diez o veinte veces más por token que el más pequeño. Además, los tokens de salida (lo que escribe el modelo) cuestan entre cinco y seis veces más que los de entrada (lo que le envías) en OpenAI, Google y Anthropic, al momento de escribir esto5. Escribir es lo caro. Un modelo procesa todo tu mensaje de una pasada, pero tiene que ejecutarse una vez por cada token que escribe.
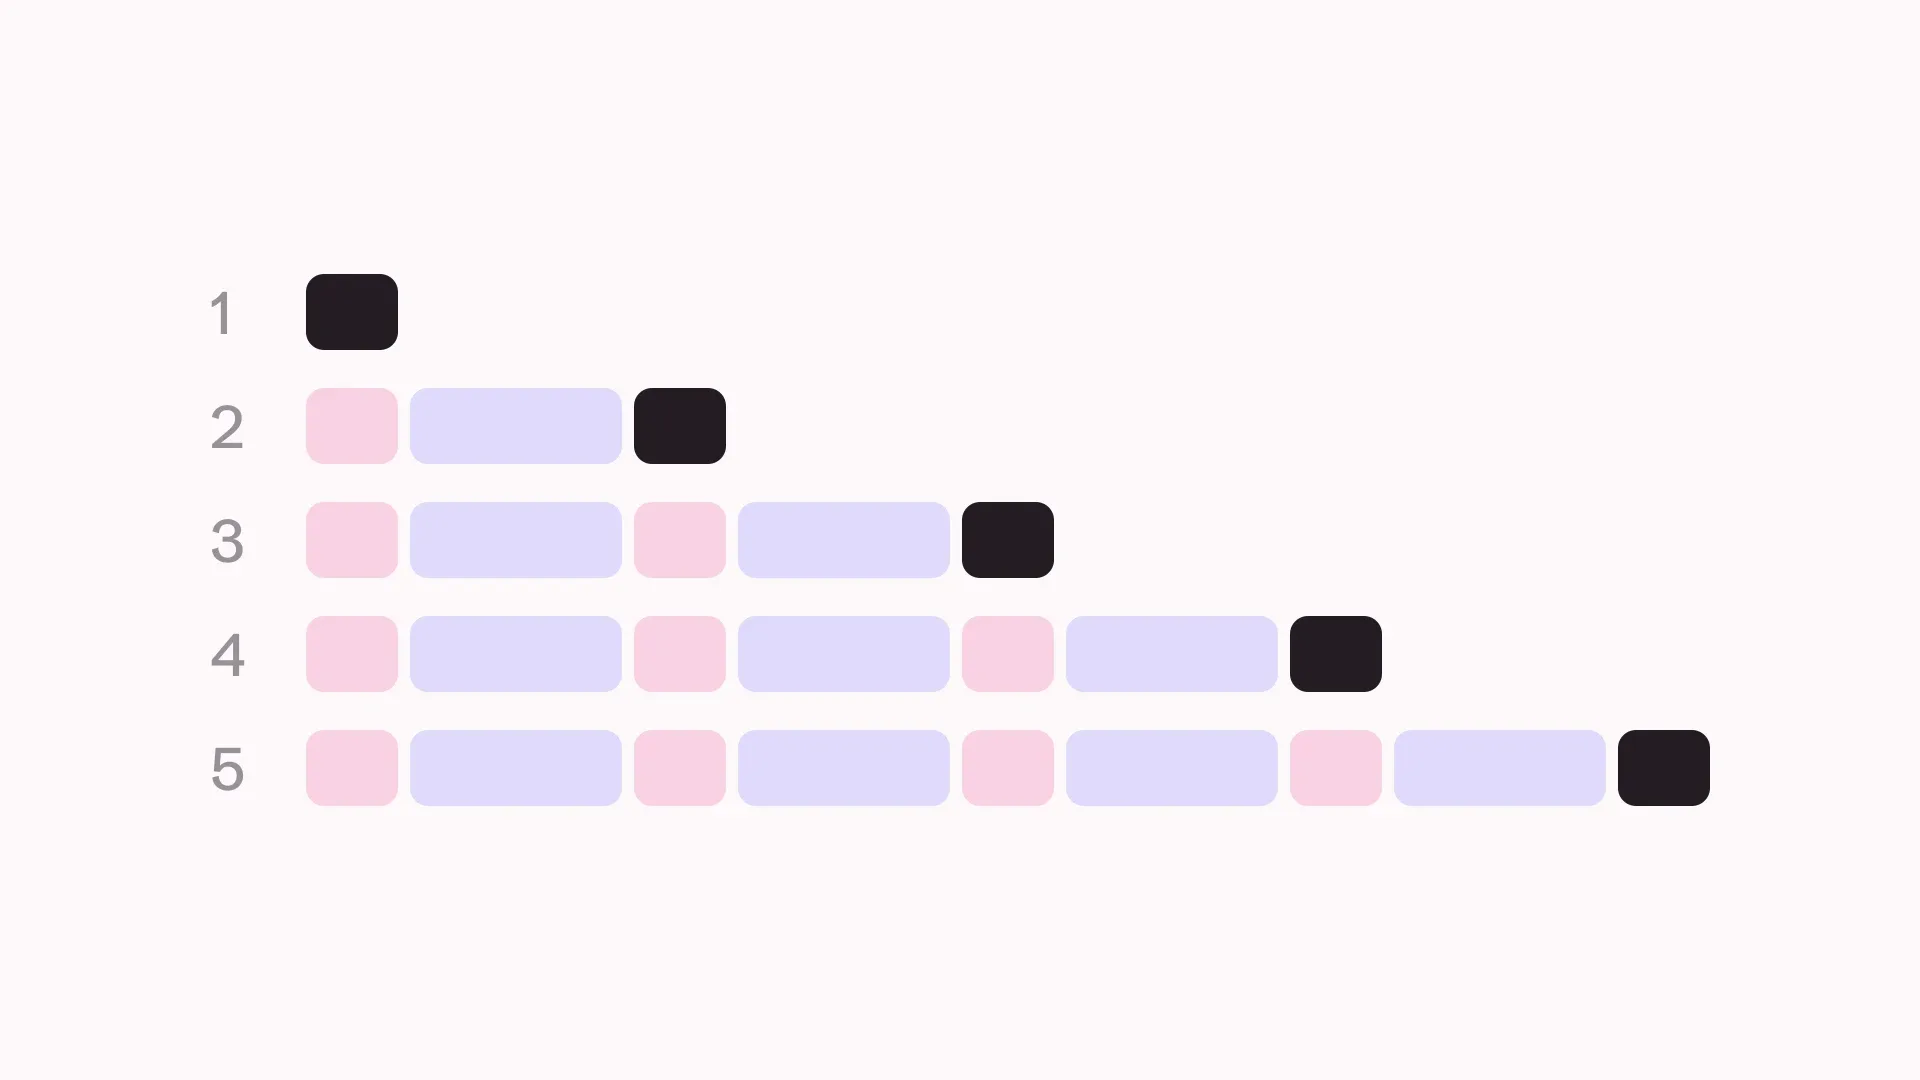
Algunos de los tokens que pagas nunca aparecen en pantalla.
- Razonamiento. Los modelos que razonan antes de responder escriben tokens para ese razonamiento. Normalmente ves un resumen o nada, pero OpenAI, Google y Anthropic cobran el razonamiento completo como salida6.
- La conversación hasta ahora. Un modelo no guarda memoria entre mensajes, así que cada vez que envías uno, se vuelve a enviar la conversación completa. El mensaje número cuarenta de un chat envía muchos más tokens que el primero. Los proveedores cobran cerca de una décima parte del precio normal por la entrada que procesaron hace poco, un descuento llamado caché, pero esa entrada de todos modos cuesta algo.
- Imágenes y archivos. También se convierten en tokens. Los modelos cortan una imagen en mosaicos o en pequeños parches cuadrados y cuentan tokens por cada uno, así que una imagen más grande cuesta más7.
Además, el mismo texto da cantidades distintas según el tokenizador. El de GPT-4o convierte la introducción de este artículo en 358 tokens, cuando el de GPT-4 necesitaba 416. Un tokenizador nuevo puede cambiar lo que pagas aunque el precio por token no cambie. Cuando Anthropic lanzó Claude Opus 4.7, mantuvo los precios de su antecesor, pero cambió a un tokenizador que convierte la misma entrada en hasta un 35% más de tokens8. Un precio por millón de tokens solo sirve para comparar modelos que comparten tokenizador.
Las suscripciones esconden todo esto detrás de una cuota mensual, pero el modelo de todas formas lee la conversación completa con cada mensaje. Empezar un chat nuevo cuando cambias de tema mantiene esa lectura corta y, en las apps cuyos límites de uso dependen del largo de la conversación, hace que el límite te dure más9.
Haz la prueba
Tiktokenizer y el Tokenizer de OpenAI muestran cómo se divide un texto. En Tiktokenizer, elige gpt-4o para obtener los mismos números de este artículo. Pega tu nombre, una frase en otro idioma o un número largo, con y sin separadores de miles. Prueba también con un emoji. 😀 es un solo token, y 🇨🇱 ocupa cuatro.
Footnotes
-
Naciones Unidas, Declaración Universal de Derechos Humanos. Los conteos usan el texto oficial del artículo 1 en cada idioma.
-
Aleksandar Petrov, Emanuele La Malfa, Philip H.S. Torr y Adel Bibi, "Language Model Tokenizers Introduce Unfairness Between Languages", NeurIPS 2023 (en inglés).
-
Aaditya K. Singh y DJ Strouse, "Tokenization counts: the impact of tokenization on arithmetic in frontier LLMs", 2024 (en inglés). Las cifras corresponden a
gpt-3.5-turbo-0301con ocho ejemplos resueltos en el mensaje. -
Jessica Rumbelow y Matthew Watkins, "SolidGoldMagikarp (plus, prompt generation)", LessWrong, febrero de 2023 (en inglés).
-
Páginas de precios de OpenAI (en inglés), Google y Anthropic, revisadas en septiembre de 2026.
-
Los modelos más nuevos de OpenAI cuentan parches de 32×32 píxeles, Google cuenta mosaicos de 768×768 píxeles y Anthropic cuenta parches de 28×28 píxeles. Ver la documentación de OpenAI (en inglés), Google y Anthropic.
-
Anthropic, Introducing Claude Opus 4.7, 16 de abril de 2026 (en inglés).
-
Los límites de Claude funcionan así, por ejemplo. Ver ¿Cómo funcionan los límites de uso y longitud?