¿Qué es un LLM?
Y ¿por qué debería importarme?
Para muchas personas, la inteligencia artificial es algo más o menos "nuevo". Si le preguntas a alguien cuándo apareció, es muy probable que te diga que fue a comienzos de la década de 2020.
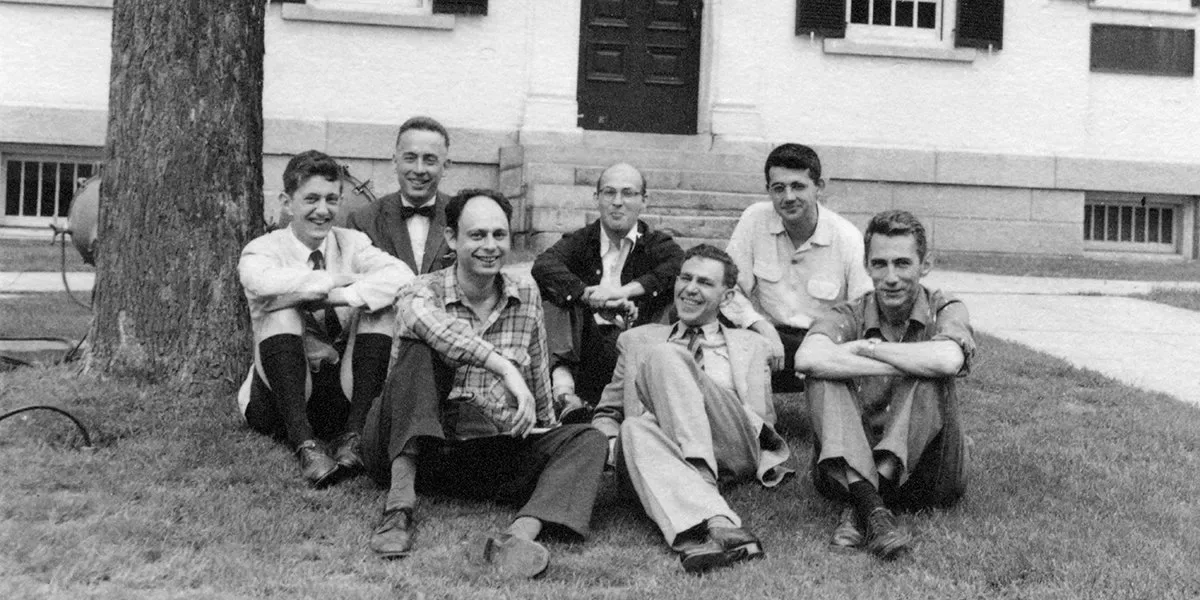
Sin embargo, el origen de la disciplina moderna se remonta a un taller de verano que se hizo en 1956, y el término propiamente tal ya había aparecido un año antes, en la propuesta para organizarlo.1 Al momento de escribir esto, la disciplina está cumpliendo 70 años.
Increíble, ¿o no? La explicación de por qué sorprende tanto es menos sorprendente: puede que estés confundiendo la inteligencia artificial con chatbots como ChatGPT, Claude o Gemini. Estos productos están construidos en torno a modelos de lenguaje de gran tamaño, conocidos como LLM por sus siglas en inglés.
Antes de seguir, hagamos una distinción:
Entonces, ¿qué son?
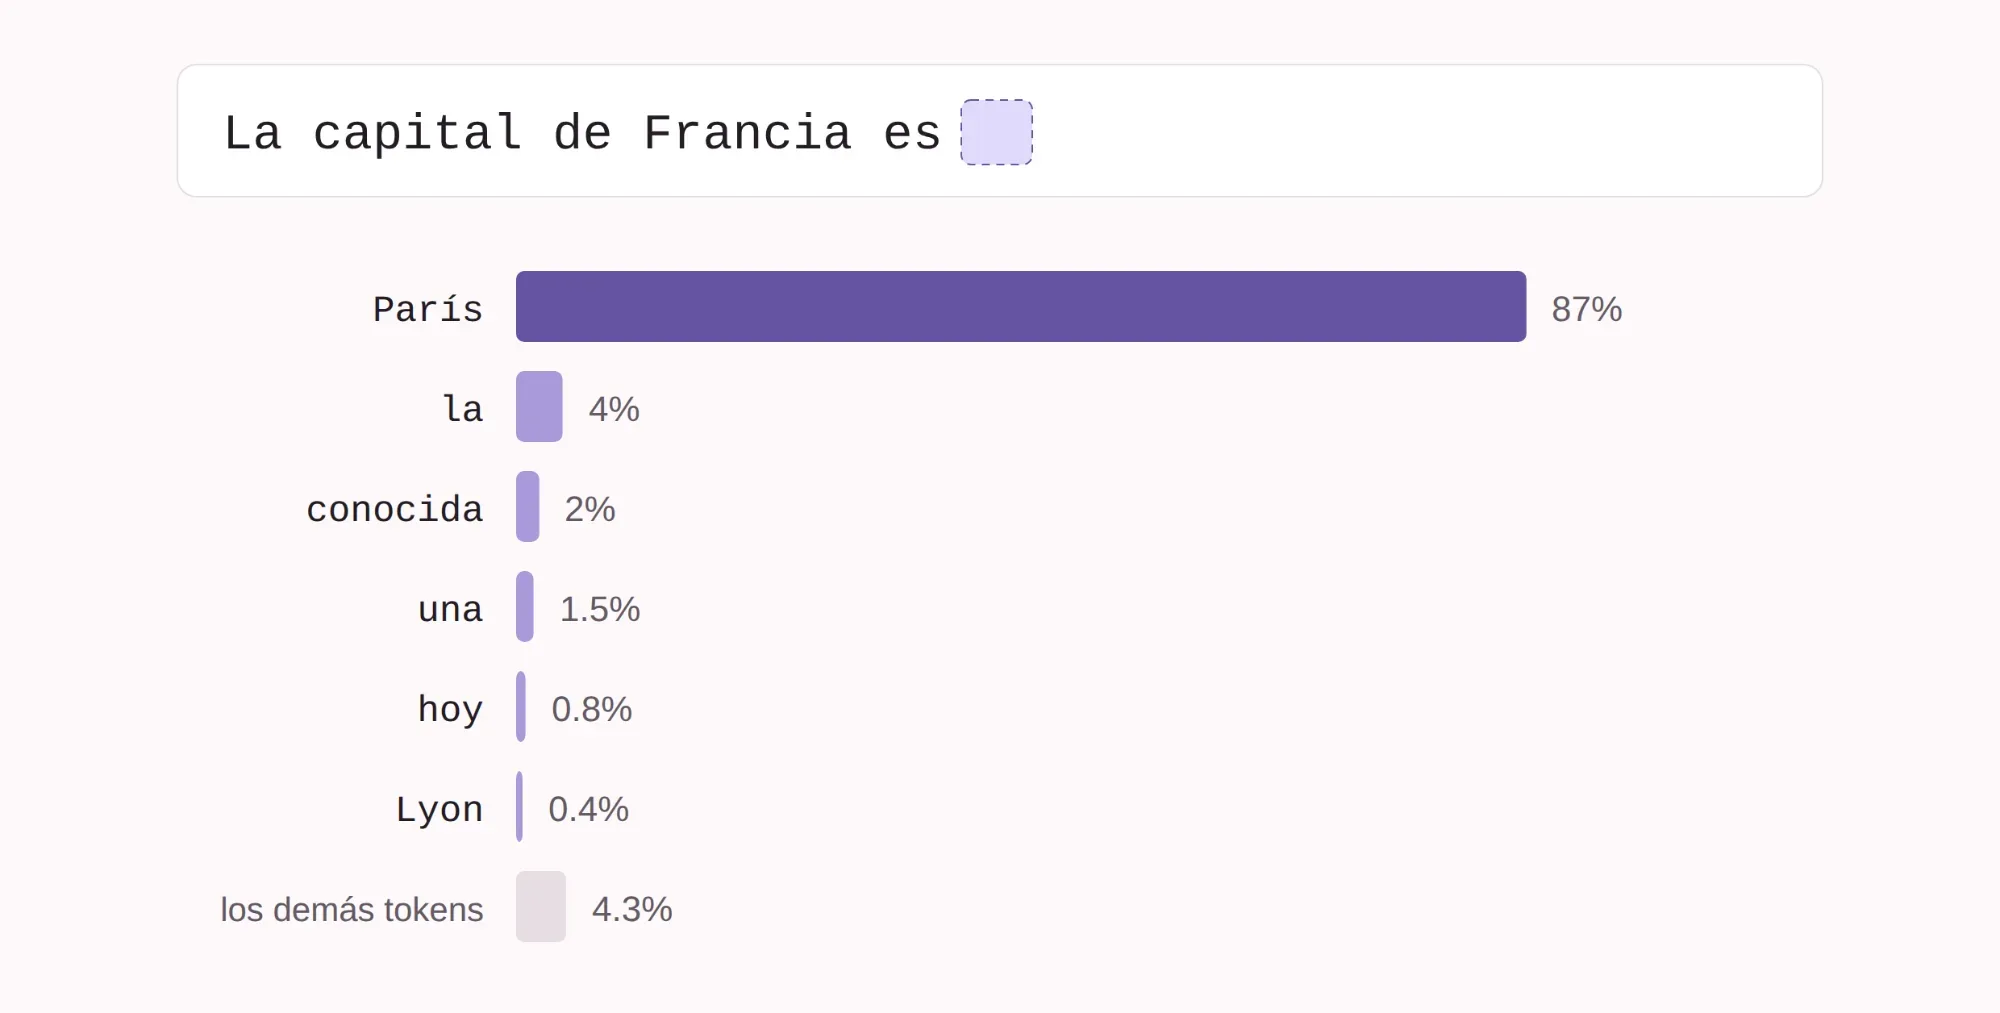
Un modelo de lenguaje basado en texto se entrena en torno a una tarea engañosamente simple: recibir un texto y predecir qué token probablemente viene después.
Si repites esa predicción una y otra vez, recibes oraciones, respuestas, código y mucho más. Los chatbots modernos agregan otras capas en torno a ese mecanismo: entrenamiento adicional, instrucciones, búsqueda y herramientas.
Desarmemos el nombre:
- Lenguaje: trabaja con texto, dividido en fragmentos llamados tokens. Un token equivale, más o menos, a una palabra (o a una parte de ella).
- Modelo: es una función matemática que contiene una enorme cantidad de números ajustables, llamados parámetros. Sus valores se aprenden durante el entrenamiento; nadie los configura uno por uno. El diseño que usa la mayoría de los LLM modernos se llama transformer y existe desde 2017.3
- Grande: se refiere a la cantidad de parámetros. Llama 3.1, el modelo publicado abiertamente por Meta (anteriormente Facebook), tiene 405 mil millones.4
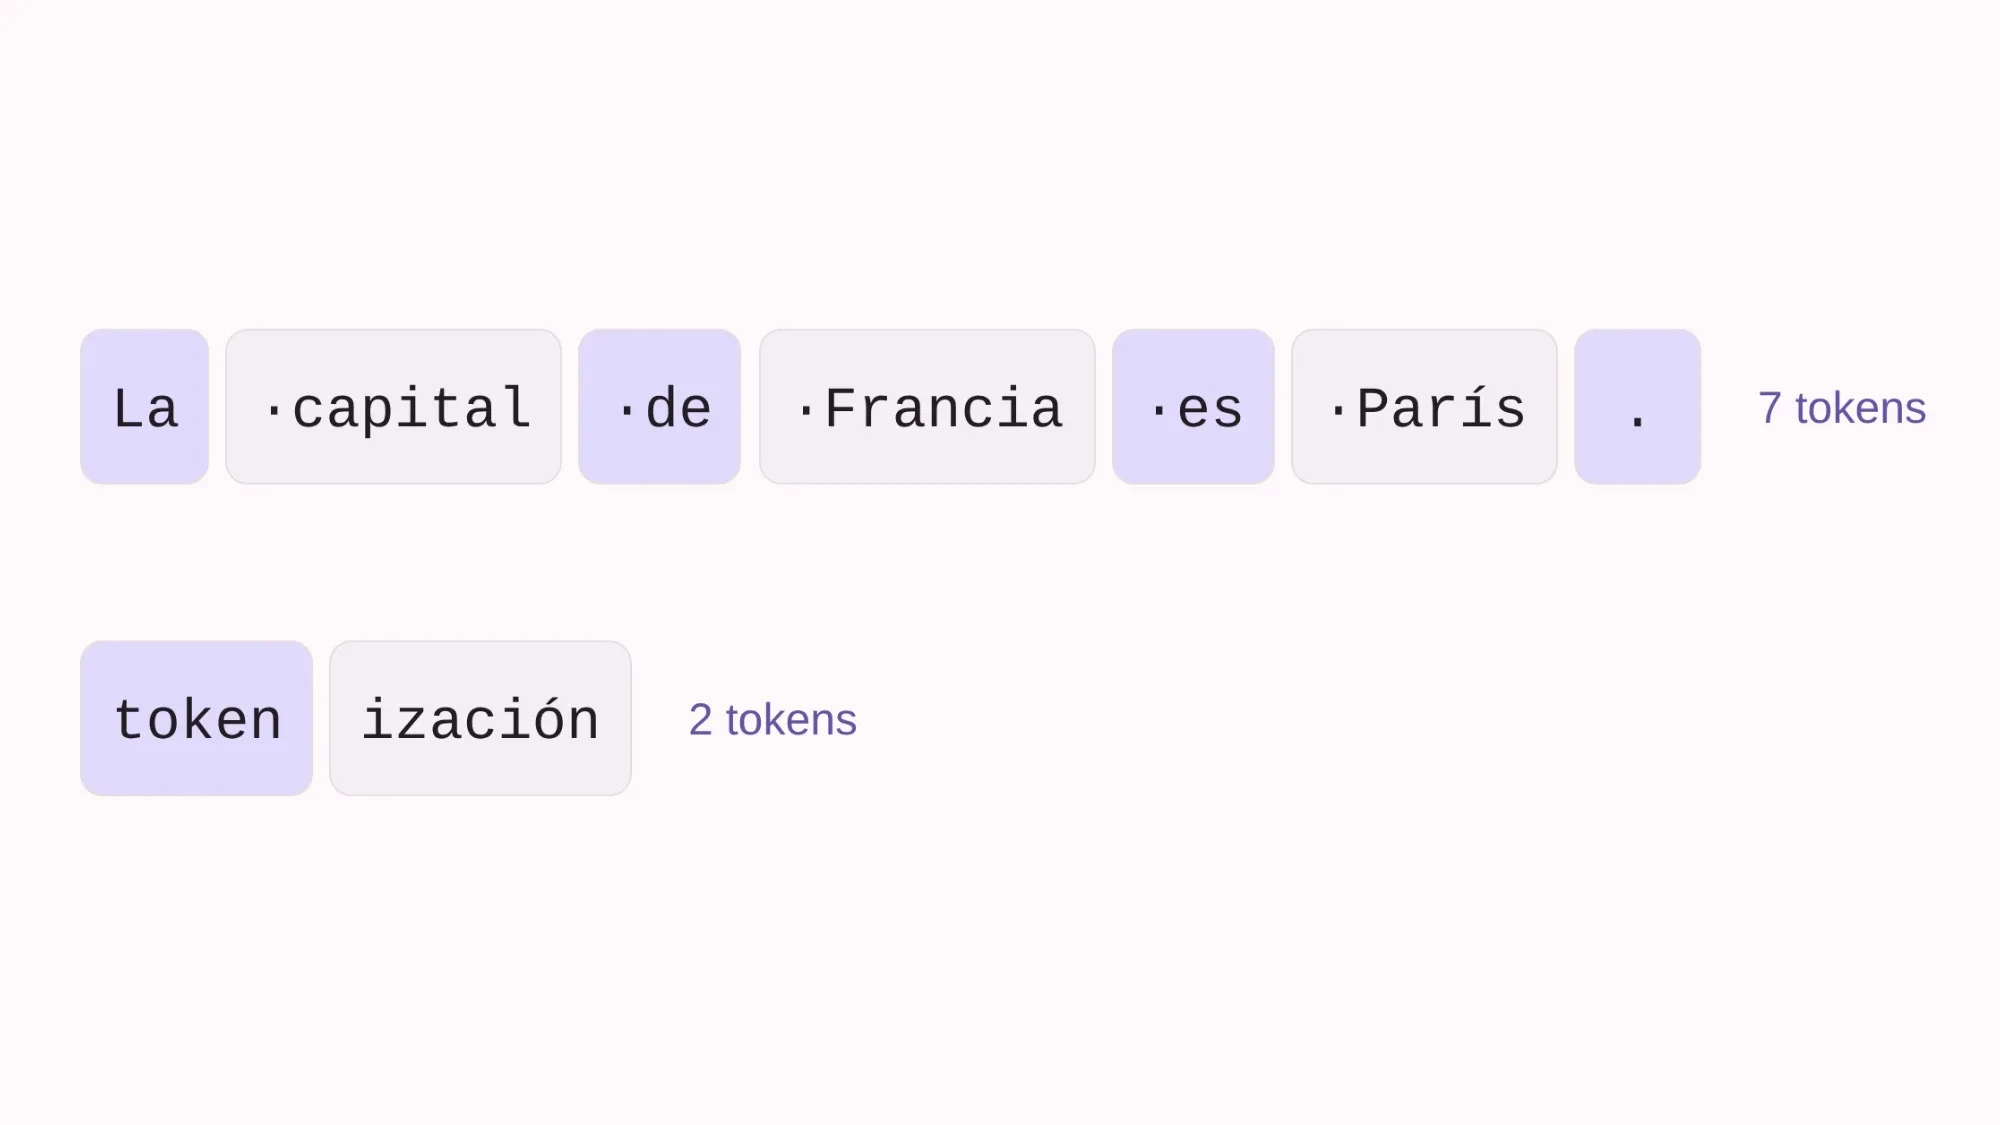
¿Y cómo se fabrica un LLM? Se le muestra un conjunto enorme y variado de textos. Se esconde el token siguiente y se le pide (al LLM) que lo adivine. Cuando se equivoca, el proceso de entrenamiento ajusta sus parámetros un poco, en la dirección que habría hecho que la respuesta fuera menos incorrecta. Después se repite, y se repite, billones de veces.
Ahora viene lo importante
Para predecir bien el token siguiente, en una variedad enorme de textos humanos, al modelo no le basta con memorizar un puñado de frases. Para completar bien una pregunta de geografía necesita saber algo de geografía. Para hacer una demostración necesita reconocer patrones matemáticos. Para contar un chiste necesita entender cómo funcionan los chistes. Para completar una oración en español necesita haber aprendido español.
La predicción del siguiente token es un caballo de Troya. Volverse demasiado bueno en predecir tokens parece producir una maquinaria interna que sirve para muchas otras cosas. Esa maquinaria se aprende durante el entrenamiento, ajuste por ajuste, en lugar de ser programada línea por línea por una persona.
Falta un último ingrediente. Un modelo que solo ha pasado por el preentrenamiento sirve principalmente para continuar textos. Si le haces una pregunta, podría responder con más preguntas, porque esa es una continuación posible. Una etapa posterior (una especie de refinamiento) le enseña a seguir instrucciones, responder preguntas y rechazar ciertas solicitudes.6 Ese entrenamiento posterior ayuda a convertir un modelo que completa texto en un chatbot.
¿Y por qué debería importarme?
Por tres razones, de menor a mayor inconveniencia.
1. Ya están presentes en cosas que usas. Pueden aparecer en tus resultados de búsqueda, tu correo, el teclado de tu celular o en el resumen de una noticia. Y la mayoría de los que te rodean los usan.
2. Resultan más convincentes justo cuando menos herramientas tienes para comprobar lo que dicen. Pregunta sobre algo que conozcas bien y vas a encontrar los errores inmediatamente. Pregunta sobre algo que no conozcas (un asunto legal, un medicamento, la historia de un país) y ese mismo tono seguro puede parecer autoridad. Al modelo no le cuesta nada sonar convincente.
3. Saber qué hace realmente cambia la forma en que lo usas. Una máquina construida para producir texto plausible puede ser realmente buena trabajando sobre material que tú le entregas: resume esto, reescribe esto, traduce esto, busca posibles fallas en mi argumento. Es harto menos confiable cuando la usas como un oráculo al que le pides datos. Muchas malas experiencias vienen de usarla al revés.
Lo que todavía no sabemos
Nadie debería esperar entender todo esto después de un artículo tan corto. A lo largo del mundo, hay investigadores trabajando a un ritmo increíble para comprender qué aprenden estos sistemas, qué cosas logran hacer de manera confiable, en cuáles fallan y por qué.
En pocas palabras: sabemos cómo se construyen y entrenan estos sistemas, pero todavía no entendemos por completo cómo su maquinaria interna aprendida produce muchas de sus capacidades y también de sus fallas. Quienes los desarrollan lo dicen derechamente: los modelos "llegan siendo inescrutables incluso para nosotros, sus desarrolladores".8 Es como entrar en una cueva oscura: sabes qué es una cueva y sabes cómo explorarla, pero todavía no sabes qué tan grande es, dónde termina ni qué hay en su interior.
Y eso me trae a este blog
Las predicciones de que esta tecnología va a salvar el mundo, o a destruirlo, son fáciles de escribir y, en mi opinión, súper inútiles.
Lo que voy a hacer acá es tomar una cosa a la vez y explicar cómo funciona realmente, de manera clara, en español y en inglés, siendo lo más honesto que pueda cada vez que la respuesta sea "todavía no se sabe".
No es necesario ser un crack en matemáticas para poder entender qué puede hacer un modelo, qué no y cuándo conviene desconfiar de sus respuestas.
Footnotes
-
J. McCarthy, M. L. Minsky, N. Rochester y C. E. Shannon, A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence, con fecha 31 de agosto de 1955; el taller se realizó durante el verano siguiente. Reproducido en AI Magazine 27(4), 2006. https://ojs.aaai.org/aimagazine/index.php/aimagazine/article/view/1904 . Dartmouth también relata la historia del evento en https://home.dartmouth.edu/about/artificial-intelligence-ai-coined-dartmouth
-
Grace Solomonoff, The Meeting of the Minds That Launched AI, IEEE Spectrum. https://spectrum.ieee.org/dartmouth-ai-workshop
-
A. Vaswani et al., Attention Is All You Need, 2017. https://arxiv.org/abs/1706.03762
-
Meta AI, Introducing Llama 3.1: Our most capable models to date, 2024. Los parámetros del modelo 405B se publicaron abiertamente, por eso podemos citar la cifra; los principales laboratorios comerciales ya no revelan la de sus modelos. https://ai.meta.com/blog/meta-llama-3-1/
-
La división exacta en tokens cambia de un modelo a otro. Sus vocabularios suelen contener entre 50.000 y 200.000 tokens, aproximadamente, dependiendo del modelo. Puedes pegar tu propio texto en el tokenizador de OpenAI para ver cómo lo divide: https://platform.openai.com/tokenizer . Más información en https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
-
L. Ouyang et al., Training language models to follow instructions with human feedback, 2022. Este artículo describe una técnica influyente de entrenamiento posterior, conocida habitualmente como RLHF. Los sistemas modernos pueden usar RLHF, otras técnicas o una combinación de varias. https://arxiv.org/abs/2203.02155
-
L. Huang et al., A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions, 2023. https://arxiv.org/abs/2311.05232
-
Anthropic, Tracing the thoughts of a large language model, 2025. https://www.anthropic.com/research/tracing-thoughts-language-model